De-esser une voix : où le placer, comment le régler, quand il ne suffit pas
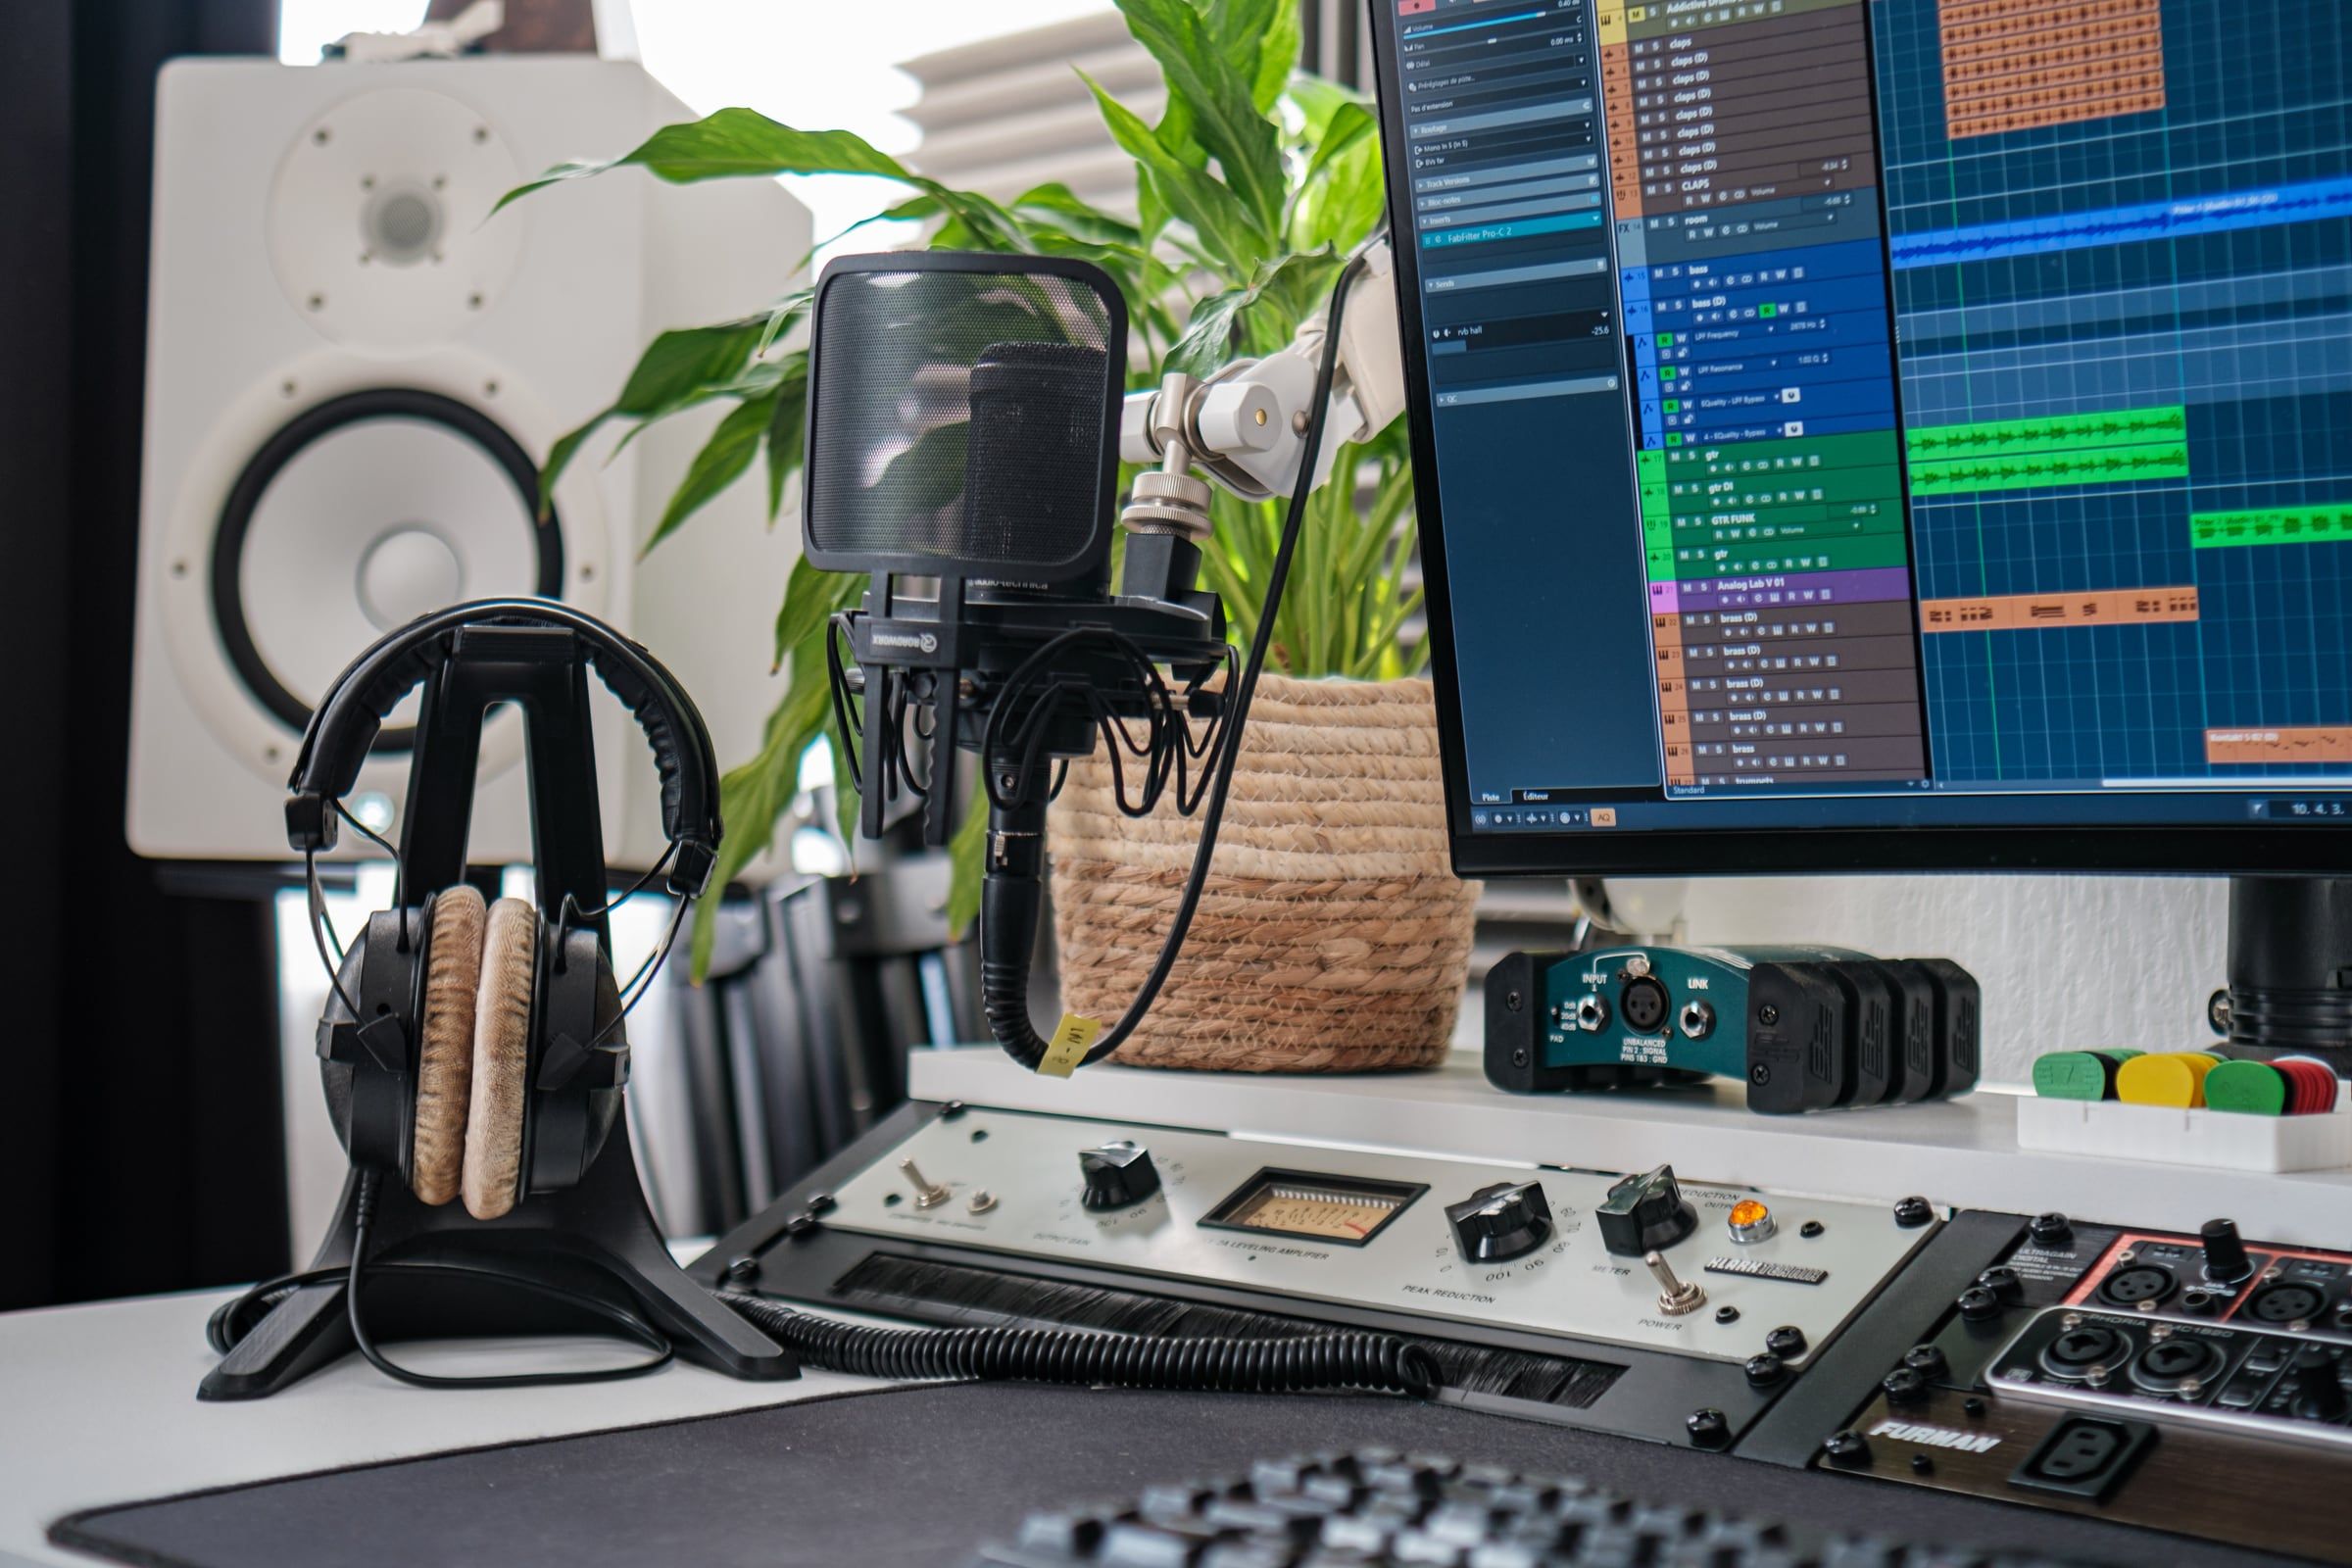
Pour de-esser une voix, placez le de-esser après le compresseur, cherchez la fréquence où les « s » piquent en écoutant la bande seule (le plus souvent entre 4 et 10 kHz), puis baissez le seuil jusqu'à ce qu'il retire quelques décibels sur chaque sifflante et rien ailleurs. Arrêtez dès que les « s » ne blessent plus l'oreille. Un cran plus loin, la voix commence à zézayer.
La méthode tient en trois lignes. Ce qui la fait varier, c'est la voix elle-même et ce qui l'entoure dans la chaîne. Voici les questions qui reviennent quand on s'y met.
À quelle fréquence sont les sifflantes d'une voix ?
Les « s », « ch », « z » et « j » sont des bruits de souffle, sans note. Leur énergie se répartit sur une large zone d'aigus, avec une région où elle se concentre et qui change d'une personne à l'autre. Sur une voix grave d'homme, cette région descend souvent vers 4 ou 5 kHz. Sur une voix plus aiguë ou très soufflée, elle monte vers 7, 8 kHz, parfois au-delà. Les « ch » se placent en général un peu plus bas que les « s ».
Un chiffre lu dans un tutoriel ne vaut donc qu'à titre de point de départ. Pour trouver la bonne fréquence, prenez une phrase chargée en sifflantes et activez la fonction d'écoute du de-esser (Listen ou Solo selon les plugins). Vous n'entendez plus que la bande surveillée. Faites glisser la fréquence jusqu'à ce que les « s » sortent nets et forts, avec le moins possible de voyelles autour. C'est là.
Un analyseur de spectre aide aussi. Mettez-le sur la piste, lisez en boucle un mot comme « sans » ou « c'est », et regardez où le pic des aigus monte au moment du « s ».
Où placer le de-esser dans la chaîne
Après la compression, dans la grande majorité des cas. Un compresseur rapproche les passages forts et les passages faibles, puis le gain de compensation remonte le tout. Les consonnes, qui étaient plus discrètes que les voyelles, se retrouvent plus en avant. Un de-esser placé avant aurait été réglé sur une voix qui n'existe plus.
Sur les voix, j'utilise le CLA-76 de Waves, une émulation du compresseur 1176. Ce type de compresseur rapide, poussé franchement, fait vite ressortir les « s », et c'est souvent après lui qu'on les entend gêner pour la première fois. Quand une voix est compressée en deux étages, comme dans la méthode pour mixer une voix rap, le de-esser se met après le second.
L'égalisation compte aussi. Si vous ajoutez de la brillance avec un égaliseur (une étagère dans les aigus pour « ouvrir » la voix), faites-le avant le de-esser, ou reprenez le réglage du de-esser après. Monter les aigus monte les sifflantes avec eux.
Certaines voix très sifflantes gagnent à avoir deux de-essers. Un premier, léger, avant le compresseur, pour que les « s » ne fassent pas réagir la compression à contretemps. Un second après, pour finir le travail. Chacun retire peu, et le résultat s'entend moins qu'un seul de-esser réglé fort.
Régler un de-esser : seuil, réduction, temps de retour
Un de-esser est un compresseur qui n'écoute qu'une bande de fréquences. Il en a donc les réglages, simplifiés.
Le seuil décide à partir de quel niveau il réagit. Baissez-le en lisant la phrase en boucle et en regardant l'indicateur de réduction. Il doit bouger sur les sifflantes et rester immobile sur les voyelles. S'il s'allume sur un « a » ou un « o » tenu, le seuil est trop bas ou la fréquence trop basse.
La réduction, ou la plage selon les plugins, limite ce qu'il peut retirer au maximum. Sur une voix chantée, 3 à 6 dB de réduction sur les « s » les plus forts suffisent souvent. Au-delà, écoutez attentivement le mot entier, et pas seulement la consonne.
Sur mes mixages, j'utilise le DeEsser livré avec Cubase ou FabFilter Pro-DS, et je fais toujours attention à ne pas les pousser trop fort. Un chanteur ou une chanteuse qui se met à zozoter s'entend bien plus qu'un « s » un peu vif, et l'auditeur ne sait pas toujours dire pourquoi la voix sonne bizarre.
Le temps de retour (release) règle la vitesse à laquelle le de-esser relâche. Trop long, il mord sur la voyelle qui suit le « s », et le début des mots s'étouffe. Les réglages par défaut des de-essers sont en général courts, et c'est rarement le paramètre à toucher en premier.
Pour juger le résultat, comparez avec et sans le de-esser au même volume, sur la phrase entière. Puis écoutez le morceau complet, la voix dans la musique. Une sifflante qui paraît agressive en solo passe souvent bien dans le mix, une fois entourée des cymbales et des guitares.
Large bande ou bande séparée ?
La plupart des de-essers proposent deux façons d'agir. En large bande, ils baissent toute la voix pendant le « s ». En bande séparée (split band), ils ne baissent que les aigus, au-dessus d'une fréquence donnée.
La documentation de FabFilter Pro-DS précise que le mode large bande sonne plus naturel, surtout sur une voix seule. Le « s » descend comme si le chanteur s'était légèrement écarté du micro, et le timbre ne bouge pas. Le mode bande séparée laisse le corps de la voix intact pendant la consonne. Il convient mieux quand les sifflantes tombent en même temps que des notes tenues ou sur une piste qui mélange plusieurs sources. Poussé trop loin, il assourdit les aigus et donne une voix terne, comme si on avait mis un tissu devant le haut-parleur.
En pratique, commencez en large bande sur une voix principale. Passez en bande séparée si vous entendez la voix entière « plonger » à chaque « s ».
Un égaliseur dynamique fait le même travail qu'un de-esser en bande séparée, avec plus de précision sur la largeur de bande. TDR Nova, gratuit, présenté dans les plugins de voix gratuits, s'en charge très bien.
Quand le de-esser ne suffit pas
Il reste parfois quelques « s » isolés, beaucoup plus forts que les autres, que le de-esser ne rattrape qu'en écrasant tous les autres. Mieux vaut alors les baisser à la main. Coupez le « s » fautif en un petit morceau de piste, et baissez son volume de quelques décibels (gain du clip, ou automation de volume), avec un fondu court à chaque bout. Dans Cubase, sur lequel je mixe depuis 2012, cela se fait directement sur l'événement audio. C'est plus long, et c'est invisible à l'écoute. Sur une voix principale, cette retouche manuelle avant tout plugin fait souvent la différence entre une voix propre et une voix « traitée ».
Si toute la prise siffle beaucoup, regardez du côté de l'enregistrement. Un micro statique très brillant, pointé droit sur la bouche, capte les sifflantes de plein fouet. Le filtre anti-pop, lui, ne retient que les plosives (les « p » et les « b »). Tourner légèrement le micro pour que le souffle passe à côté de la capsule les adoucit déjà, sans toucher au reste. L'article pour enregistrer une voix chez soi détaille le placement du micro et la distance.
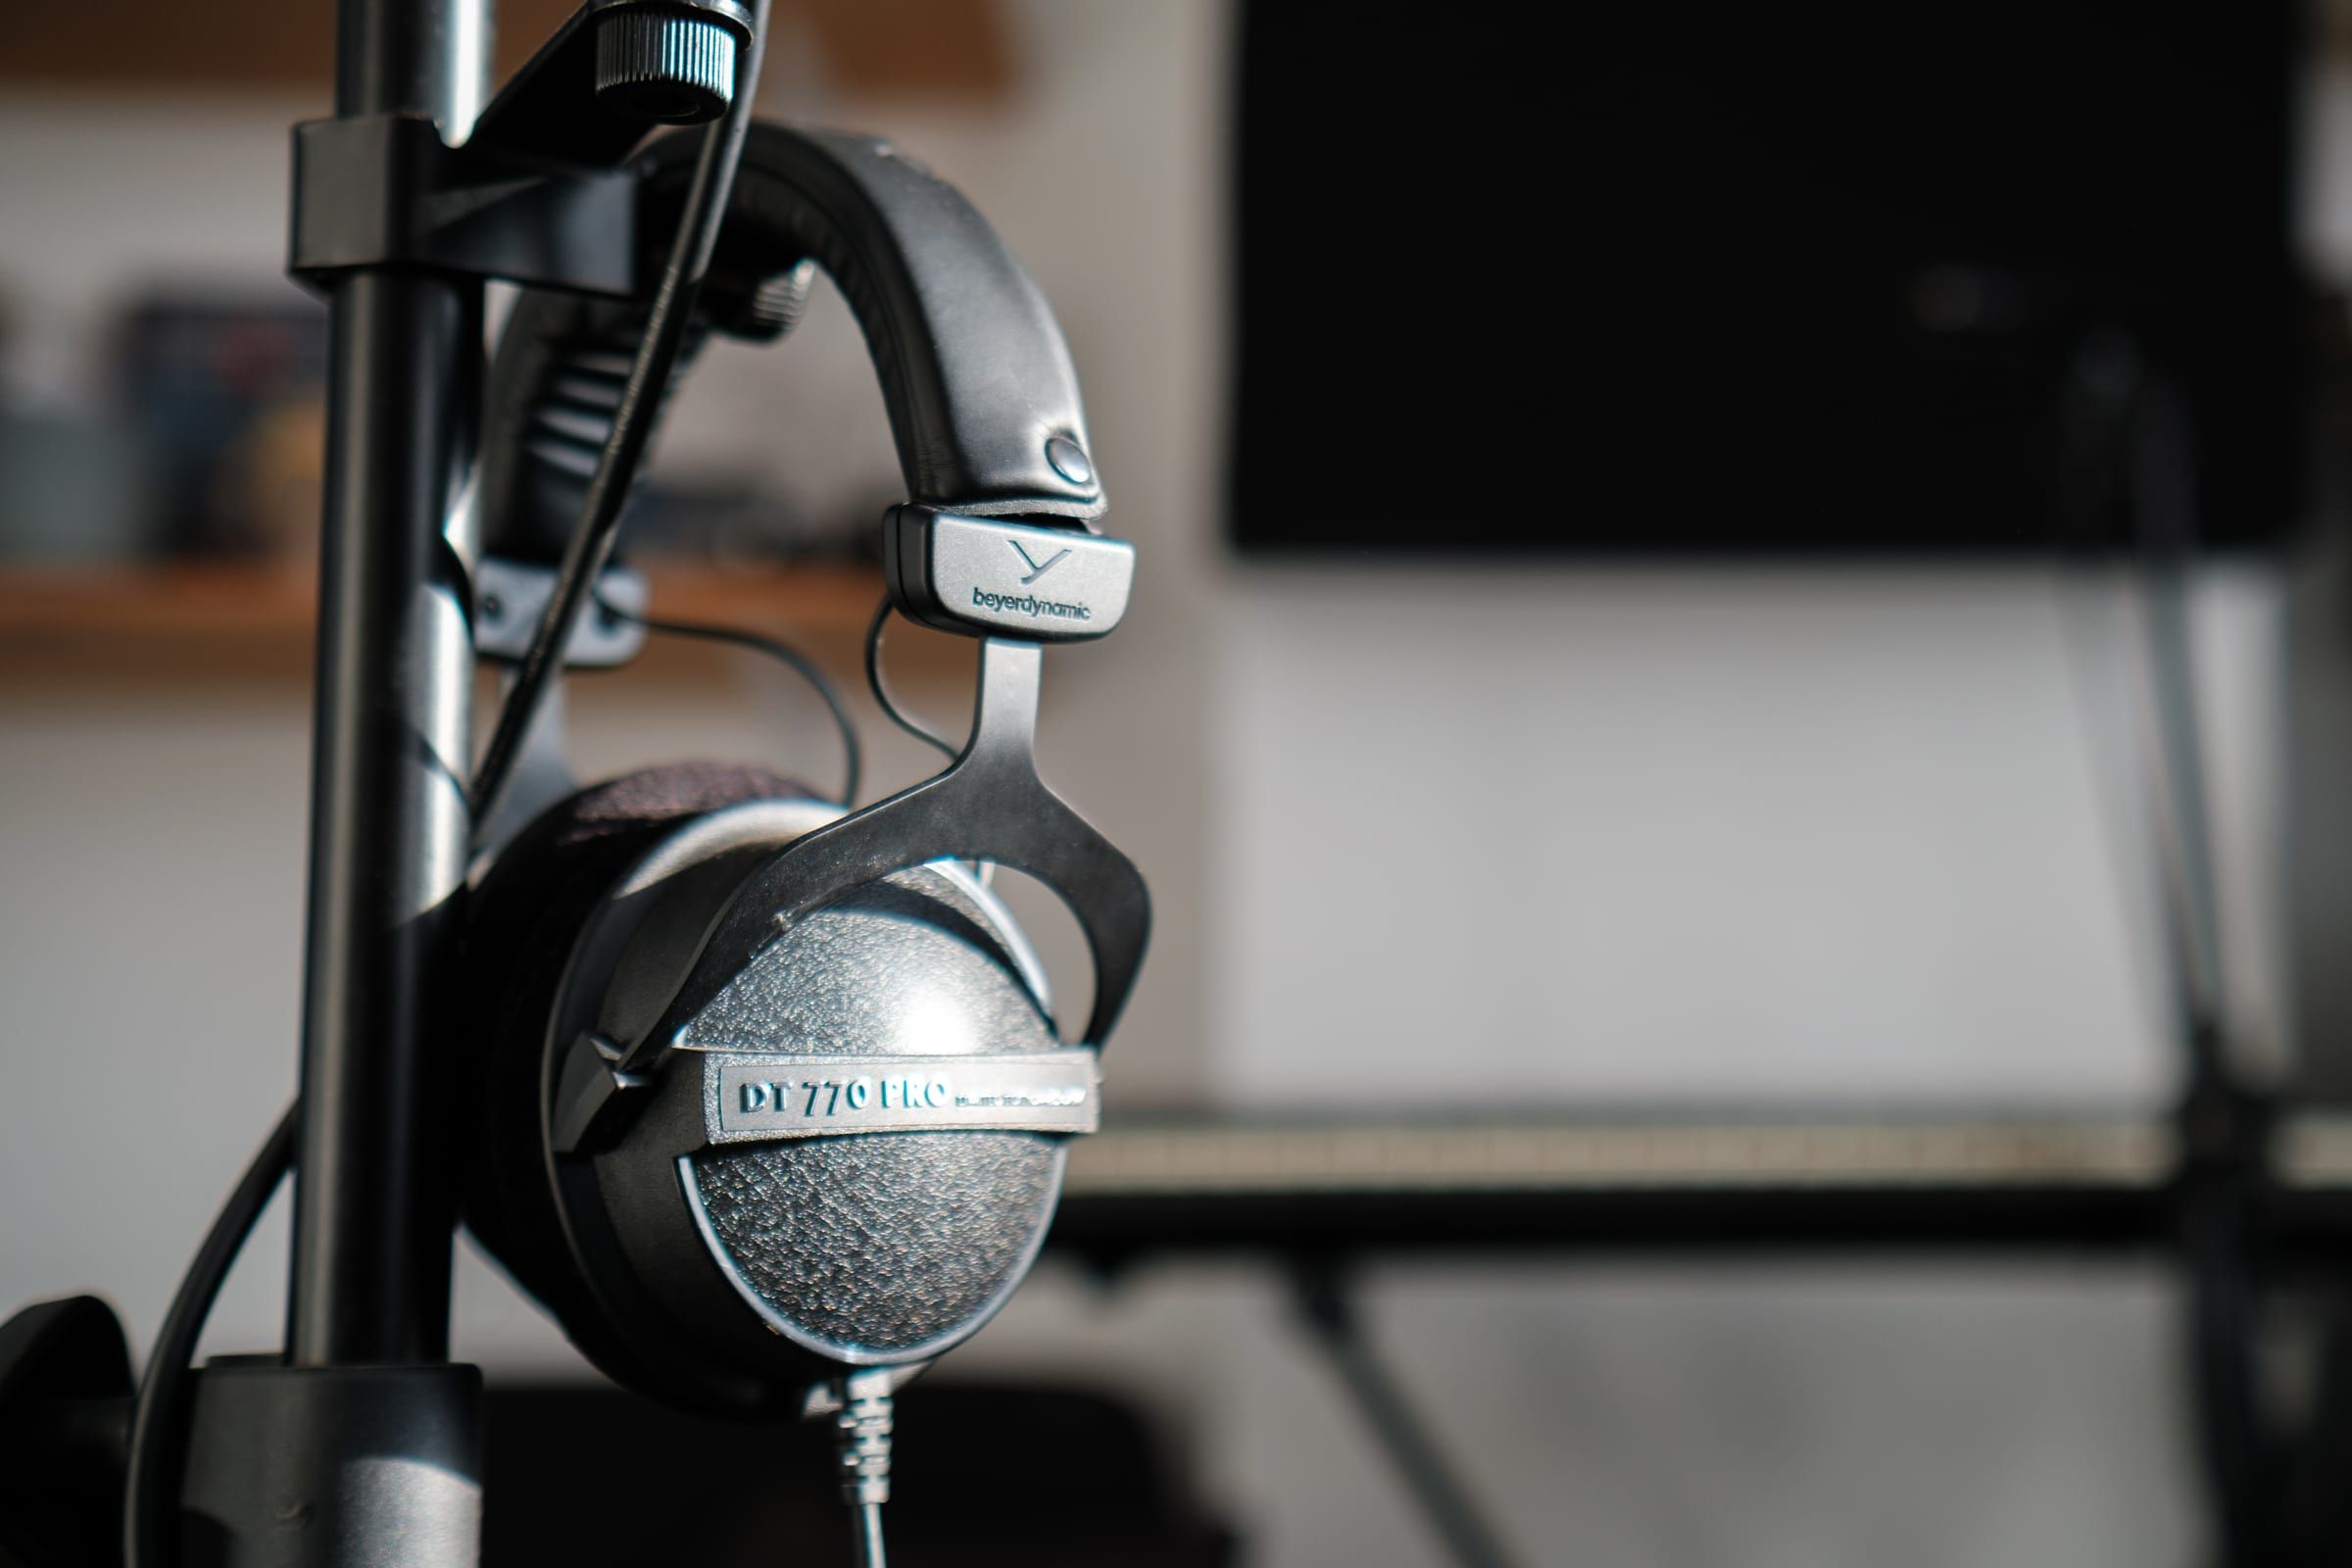
Le casque joue aussi des tours. Les aigus y paraissent souvent plus présents qu'en enceintes. Au studio, je travaille au DT 770 PRO de Beyerdynamic, dont les aigus marqués aident à repérer les sifflantes, et qui pousse justement à en enlever un peu trop. Vérifiez votre réglage sur des enceintes ou des écouteurs ordinaires avant de le valider.
Les sifflantes dans la reverb et le delay
Une voix bien de-essée peut encore siffler à travers ses effets. Chaque « s » envoyé dans une réverbération longue ou un delay revient en traînée d'aigus, répétée, parfois plus visible que la voix sèche.
La parade est simple. Placez un de-esser en entrée de la piste d'effet, avant la reverb ou le delay, et réglez-le nettement plus fort que sur la voix. Une queue de réverbération un peu sourde passe inaperçue. Un « s » qui rebondit trois fois dans le delay s'entend tout de suite. Couper un peu d'aigus sur le retour de l'effet aide aussi.
Et au mastering ?
Un ingé son de mastering peut adoucir des sifflantes restées trop fortes, avec un de-esser en bande séparée réglé sur l'ensemble du morceau. Il agit alors comme un limiteur des aigus. Le problème est qu'il ne distingue pas un « s » d'un coup de charleston ou d'une cymbale qui tombe au même moment. Plus la correction est forte, plus le haut du mix perd son éclat.
Les sifflantes se règlent donc au mixage, sur la piste de voix. Si votre mix est déjà validé et que les « s » vous gênent, le mastering depuis des stems permet de traiter la voix à part, comme expliqué dans l'article sur le stem mastering.